浏览器自动化——让ai执行任何可由浏览器完成的操作
网站没开放 API 也没关系:凡是能在浏览器里点、填、读、下载的动作,都能写成一串步骤交给 Agent 跑。
非正式文章
准备工作
安装包browserskill_setup_kit.zip · 约 7 MB包里已含 skill 本体、运行环境和安装提示词,不用另找。
先把刚下载的 zip 包拖给 Agent,再复制这句话发过去。
解压这个包,按里面的 browser_skill_install_prompt.md 配置 browser-skill。接下来是比较漫长的等待,直到ai按提示词执行完成。提示词跑完会出现一条带链接的提示(如下图),点它去装浏览器插件。
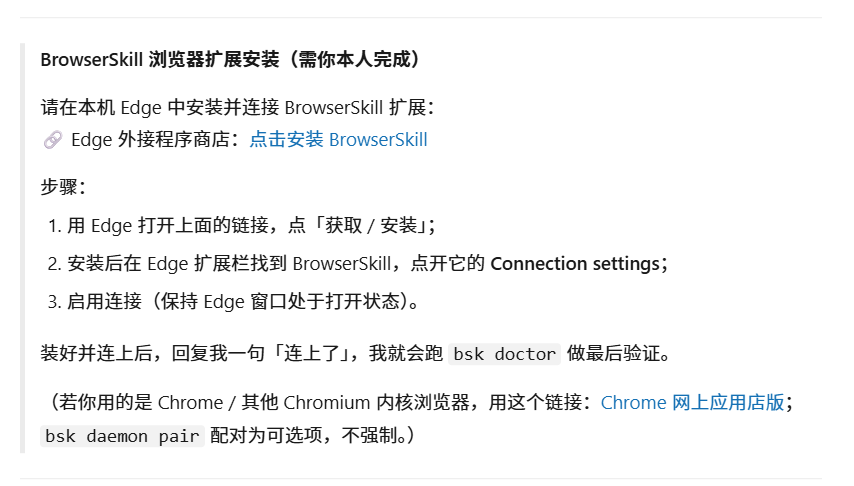
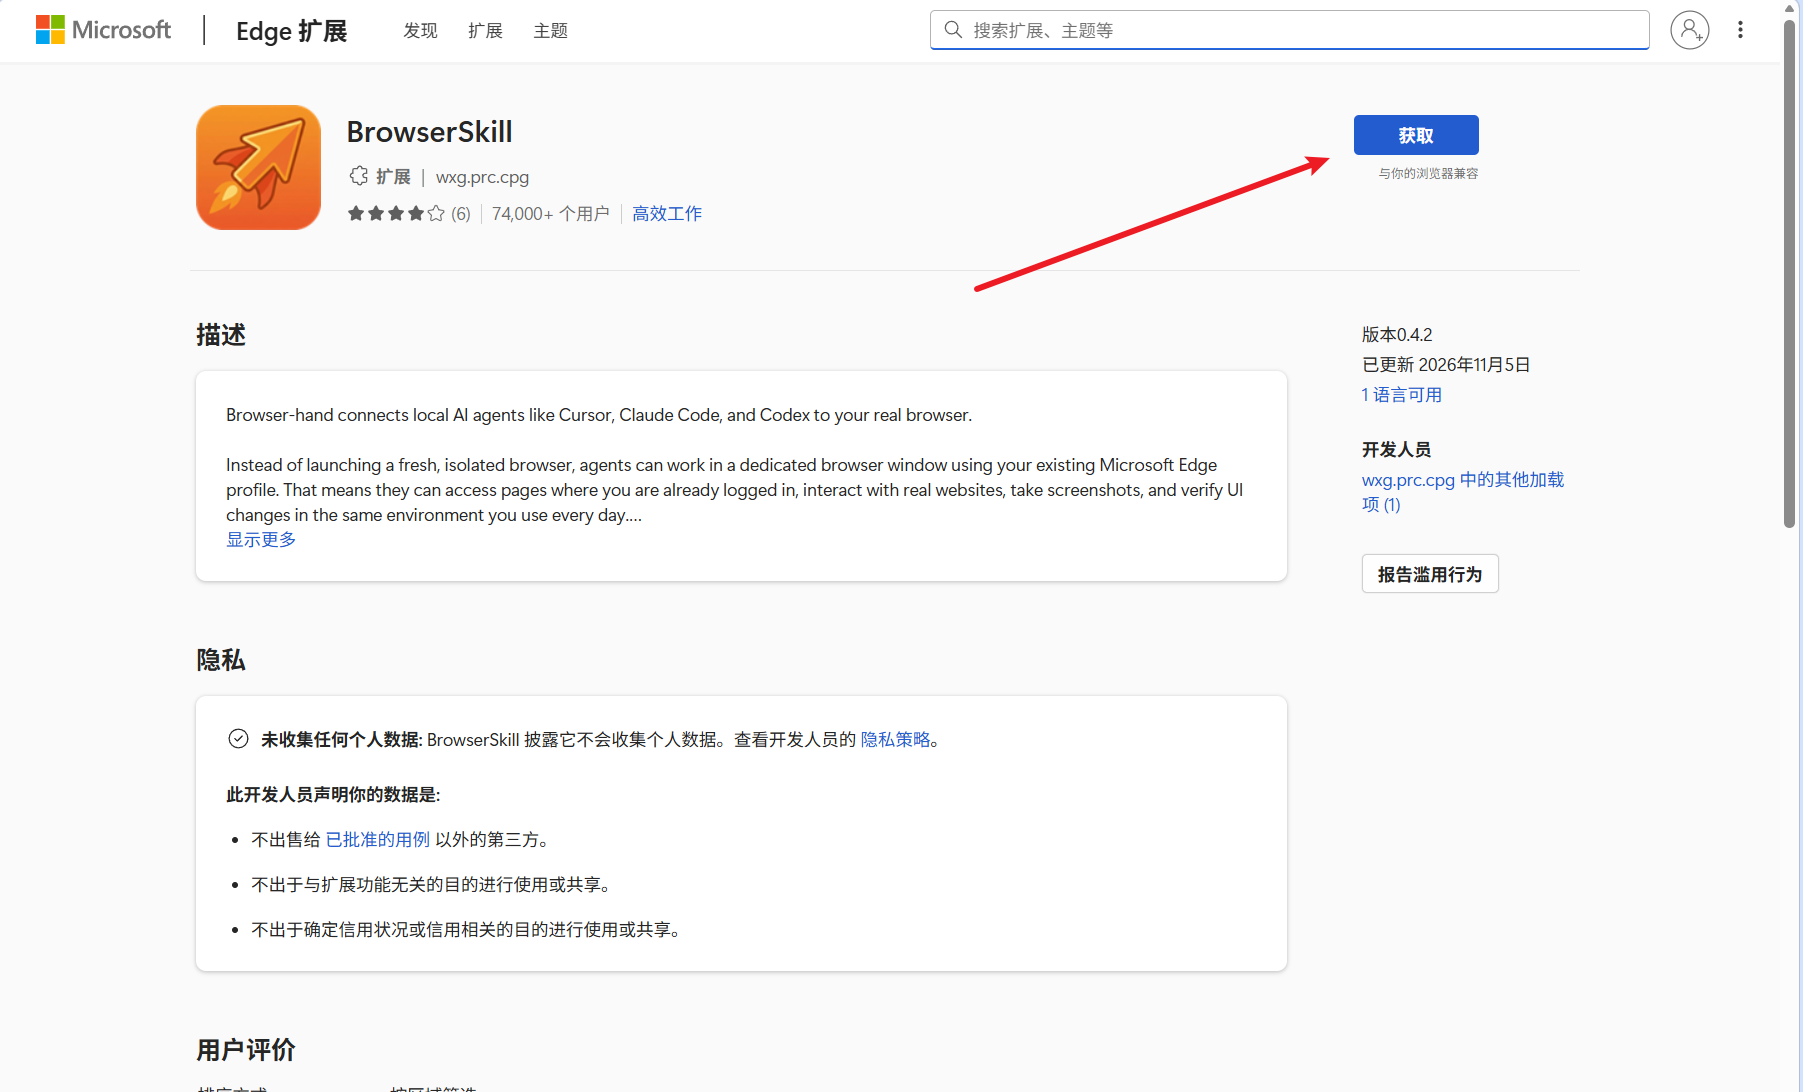
点击链接将跳转到这样的画面(这里以edge为例),继续点击获取,插件安装完成后先不要关闭窗口,而是回到会话中,提醒Agent继续下一步。
调用skill
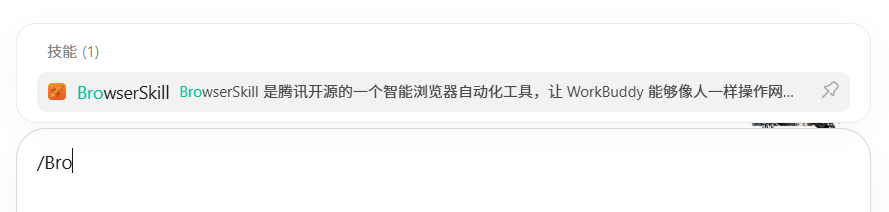
装对了,调用技能时会在列表里看到 browser-skill。
对普通人而言,我们可以使用该skill尝试以下操作(记得先调用技能!!):
办公场景(解放双手与重复劳作)
把 Excel 数据录进没有 API 的老系统
ERP、财务报表、人事打卡这类老系统没开放接口。让 AI 自动登录后台,把表格一行行录进网页,或批量完成问卷、报名信息的填写与重复提交。碰上短信验证码或 CAPTCHA,它会把控制权交还给你,验完接着跑。
不用写爬虫,抓竞品页面出表
一句「抓某网站前 20 条标题和链接」「把这几个竞品页的价格和销量整理成表」就够了。它自己翻页、提元素,直接导出 Excel 或 CSV;也能每天定时巡检竞品站、百度指数、微信指数,生成行业周报。
网页后台的私信与发布流程
读小红书、抖音、企业微信网页版的私信列表,按知识库拟好回复并点发送。运营岗还能走完选题、网页草稿、封面上传、定时发布这一串。
不用写测试代码的网页巡检
定时模拟真实用户的网络异常、清本地缓存、批量跑跨浏览器兼容测试,用来排查公司网页的可用性。
学习与研究场景(对抗信息过载)
按关键词追论文,自动摘摘要
每天追 HuggingFace、arXiv 上特定领域的新论文,自动翻页、筛元数据、提摘要,顺手做一遍中译。再进一步可以接上 LaTeX 即时编译。
多平台热榜聚合成一份晨报
设一个每天早上 7 点跑的智能体,去知乎、B 站、微博、Twitter 看热榜或指定博主主页,滤掉广告和无关内容,汇总成简报推到飞书或微信。
把文章丢进知识库,自动摘要打标签
给一个 URL,它后台打开页面读全文,提核心观点和标签,存进 Notion 或本地 Markdown,慢慢攒出能语义搜索的第二大脑。
课程页里的 PDF 批量下载改名
一句「进入课程页,翻页下载所有 PDF,按章节重命名」,省掉几十次右键另存为。
上述场景可能依旧有些泛,归根结底只要记住一点,我们能在网页中做什么,它就能做什么。